Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning 2025.8.5 作者:Bowen Jin , Hansi Zeng , Zhenrui Yue , Jinsung Yoon $^{3}$ , Sercan Ö. Arik $^{3}$ , Dong Wang , Hamed Zamani , ==Jiawei Han==
deepseek r1+搜索引擎
目录
一、核心问题与创新
二、核心架构
RL 训练框架: 将搜索引擎建模为环境的一部分,支持 PPO 和 GRPO。
多轮交错交互: 支持“推理-搜索-再推理”的动态链条。
检索 Token 掩码: 关键的稳定训练技术,仅优化模型生成的 Token。
奖励机制: 证明了简单的结果导向奖励足以涌现复杂的搜索行为。
三、实验
1、实验目标
2、基准与指标
3、核心结果与对比分析
一、核心问题与创新
当前 LLM 在处理需要外部知识的复杂任务时面临的核心瓶颈:不仅需要推理能力,还需要高效获取最新信息的能力,而现有的结合方式并不完美。
具体体现在两个层面:
RAG 的局限性:传统的 RAG(检索增强生成)通常是“先检索后生成”的静态流程。LLM 并没有经过训练去学习“如何与搜索引擎交互”,仅仅是被动接收检索结果,这在处理复杂多跳问题时往往效果不佳 4。
工具学习的依赖性:现有的让 LLM 使用搜索工具的方法(如 Toolformer)主要依赖大量高质量的 SFT(监督微调)数据。这种数据获取昂贵且难以扩展,且搜索操作本身的不可微性使得端到端优化变得困难 5。 (RAG方法难以进行动态多轮检索)
本文的核心命题是: 如何利用强化学习(RL),在仅依赖最终结果奖励的情况下,让 LLM 自主学会“边思考、边搜索、边推理”的复杂行为?
核心创新点:
Search-R1 框架:提出了一种新的 RL 框架,允许 LLM 在推理过程中自主生成搜索查询,并将搜索结果作为环境反馈整合到上下文中,形成多轮交互 6。
检索 Token 掩码 (Retrieved Token Masking):为了解决 RL 训练的不稳定性,提出在计算策略梯度时,对检索回来的文本内容进行 Loss Masking。即只优化模型生成的思考和查询 Token,而不优化外部检索回来的文本 7。
结果导向的极简奖励:证明了不需要复杂的步骤奖励(Process Reward),仅凭最终答案的正确性(Outcome Reward),就能驱动模型涌现出自我修正、多跳搜索等高级能力 8。
核心思路
核心思想:将搜索引擎建模为强化学习环境的一部分,使 LLM 能通过试错自主学习:
- 搜索即环境交互:将搜索 API 调用转化为马尔可夫决策过程的状态转移
- 结构化文本生成:通过特殊标记实现程序化控制
- 轻量化奖励设计:仅用最终答案正确性作为奖励信号,避免复杂过程监督
二、核心架构
Search-R1 的核心是一个基于 RL 的闭环系统,主要包含以下关键模块:
1. RL 训练框架 (RL with Search Engine)
定义:将搜索引擎 $\mathcal{R}$ 视为环境的一部分。优化的目标函数不仅包含模型自身的生成,还包含了与搜索引擎交互产生的轨迹 9。
兼容性:该框架同时兼容 PPO (Proximal Policy Optimization) 和 GRPO (Group Relative Policy Optimization) 两种主流 RL 算法 10。
PPO:基于 Actor-Critic,训练更稳定,但收敛较慢 11。 演员/策略网络(负责根据状态采取动作)-评论家/价值网络(负责打分)
GRPO:不需要 Critic 模型,通过组内相对优势来更新,收敛速度快,但在长步数训练后可能不稳定 。
2. 多轮交错交互 (Interleaved Reasoning and Search)
流程:模型生成的轨迹是“思考”与“搜索”交织的。(允许无缝插入搜索操作)
特殊 Token 设计:
<think>...</think>:包裹模型的推理过程。<search>...</search>:触发搜索引擎的查询。<information>...</information>:包裹搜索引擎返回的外部知识。<answer>...</answer>:最终答案。
机制:系统检测到
<search>标签后,自动调用搜索引擎,将结果插入到<information>中,模型基于更新后的上下文继续生成,直到输出最终答案或达到最大步数 13。
3. 检索 Token 掩码 (Retrieved Token Masking)
问题:Rollout 序列中包含了模型生成的 Token 和检索回来的 Token。如果对检索回来的 Token 也计算梯度及 KL 散度,会导致优化目标偏移(因为这些内容不受模型参数控制)。
解决方案:引入掩码机制 $I(y_t)$。
如果 $y_t$ 是模型生成的(如思考、查询),$I(y_t)=1$。
如果 $y_t$ 是检索回来的文本,$I(y_t)=0$。
作用:确保策略梯度只在模型可控的部分生效,极大地稳定了训练过程 14。
4. 奖励建模 (Reward Modeling)
策略:放弃复杂的格式奖励或过程奖励,仅使用最终结果奖励。
计算:$r_{\phi}(x,y) = EM(a_{pred}, a_{gold})$。即检查生成的最终答案与标准答案是否完全匹配(Exact Match)15。
发现:虽然没有显式的格式奖励,模型在 RL 过程中自动学会了保持结构化的输出格式 16。
三、实验
1、实验目标
验证 SEARCH-R1 在需要外部知识和复杂推理的任务中,是否能超越传统的 RAG 基线及其他 RL 微调方法。
2、基准与指标
A、数据集
涵盖 7 个问答数据集,分为两类 17:
通用问答:NQ, TriviaQA, PopQA。
多跳问答 (Multi-Hop):HotpotQA, 2WikiMultiHopQA, Musique, Bamboogle。
why not hit-rate mrr?命中率及平均倒数排名
B、基准方法
对比了三大类方法 18:
无检索推理:Direct Inference, CoT。
检索增强推理:Standard RAG, IRCoT (Iterative Retrieval CoT), Search-o1。
微调方法:SFT (Supervised Fine-Tuning), R1 (纯 RL 无搜索), Rejection Sampling (拒绝采样)。
模型基座:Qwen2.5-7B 和 Qwen2.5-3B 19。
3、核心结果与对比分析
1. 性能对比:显著超越
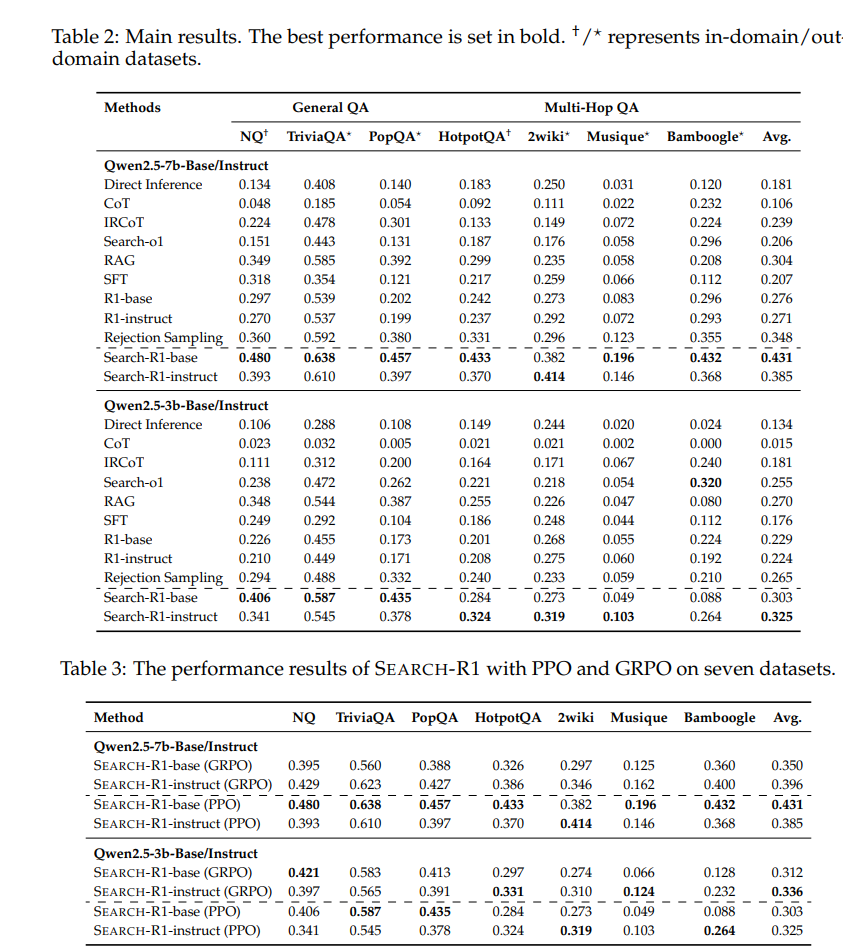
主要结果:SEARCH-R1 在所有数据集上均优于强基线。
Qwen2.5-7B 版本比 RAG 平均提升 24% 20。
Qwen2.5-3B 版本比 RAG 平均提升 20% 21。
多跳能力:在 MuSiQue 等复杂多跳数据集上,Search-R1 表现出巨大的优势(例如 Qwen2.5-7B 在 MuSiQue 上得分 0.196,而 RAG 仅为 0.058),证明了其自主多步搜索的有效性 22。
- 模型能够通过连接多个离散的信息点或经过多个逻辑步骤来回答复杂问题的能力
2. 训练动态分析
PPO vs GRPO:GRPO 收敛更快,但 PPO 训练更稳定。最终两者的效果相当,建议优先使用更稳定的 PPO 23。
Base vs Instruct:Instruct 模型收敛更快,但 Base 模型通过 RL 训练后,最终能达到与 Instruct 模型相似的性能水平。这表明 RL 能有效填补预训练模型在指令遵循上的差距 24。
3. 行为分析:涌现出的智能
搜索频率:随着训练步数的增加,模型主动调用搜索的次数显著增加,说明模型“学会”了搜索是有用的 25。
自我修正:案例研究显示,Search-R1 能够在第一轮搜索信息不足时,自主发起第二轮搜索进行补充验证(Self-Verification),这是纯 SFT 难以做到的 26。
4. 消融实验
- Masking 的重要性:去除了 Retrieved Token Masking 后,模型性能在所有数据集上均有显著下降(平均从 0.431 降至 0.343),证明了该技术对稳定训练至关重要 27。
rewarding syntax?仅看结果,不看过程
search-r1生成高质量数据-微调一个Bi-encoder让 Retriever 在看到 Query 时,就能隐式地“感知”到 Search-R1 经过漫长推理后才找到的那个文档
- 兼容性:框架设计支持任意 API 调用(如计算器、数据库)
- 挑战:需要为不同工具设计专用掩码策略,例如数据库查询结果可能包含结构化数据
为什么要用强化学习 + 搜索而不是监督学习 + 搜索?
技术细节:
- 多轮搜索的决策树复杂度呈指数增长(3 轮搜索可能有 $10^6$ 种路径),监督学习难以覆盖所有情况
- 强化学习的试错机制能自主发现最优搜索策略,如论文表 5 案例中模型自动进行验证性检索
检索 Token 掩码(retrieved Token masking)的作用是什么?为什么它可以提高训练的稳定性?
在强化学习中,模型的目标是通过调整策略来最大化奖励。如果没有检索 token 掩码,模型可能会尝试直接修改检索到的文本,以获得更高的奖励。这会导致以下问题:
- 信息污染:模型可能会改变检索到的信息,使其与事实不符,从而损害模型的知识来源。
- 训练不稳定:模型可能会过度关注检索到的文本,而忽略了自身推理能力的提升。
检索 token 掩码通过阻止模型修改检索到的 token,强制模型专注于如何更好地利用这些信息。这可以避免信息污染,并促使模型学习更有效的推理和搜索策略,从而提高训练的稳定性。
SEARCH-R1 如何解决多轮交互的问题?
SEARCH-R1 的核心创新在于它允许 LLM 在推理过程中自主决定何时以及如何进行搜索。通过引入 <search> 和 </search> 等特殊 token,LLM 可以在生成文本的过程中,显式地发出搜索请求。系统会根据这些 token 提取查询语句,调用搜索引擎,并将检索结果以 <information> 和 </information> 的形式插入回 LLM 的上下文。
这样,LLM 就可以根据实时检索到的信息,动态调整其推理路径和搜索策略,实现真正意义上的多轮交互。### 为什么文章选择使用基于结果的奖励函数,而不是基于过程的奖励函数?
基于过程的奖励函数需要对模型的中间推理步骤进行评估,这通常需要人工标注或复杂的规则。这不仅增加了成本和复杂性,而且也容易引入人为偏见。
基于结果的奖励函数只关注最终答案的正确性,避免了对中间步骤的评估,更加简单和通用。文章的实验结果表明,即使只使用简单的基于结果的奖励函数,SEARCH-R1 也能有效地学习到复杂的推理和搜索策略。